Knuth-Morris-Pratt
0、声明
- 钦定一个字符串的前缀和后缀不包含它本身。
- 字符串以 $1$ 为下标起点
KMP 通常解决的是单模式串匹配问题,即,给定两个字符串 $s,t$,求出 $s$ 在 $t$ 中出现的次数。
1、Border 以及 Next 数组
首先暴力枚举是
一个长度为 $l$ 的字符串有 $l-1$ 个前缀以及 $l-1$ 个后缀。
设字符串 $s$ 的前缀所构成的集合为 $\Pi$,后缀所构成的集合为 $\Sigma$,定义该字符串的 Border 为:
$$
{\displaystyle\max_{x\in\Pi\cap\Sigma}|x|}
$$
$|x|$ 为字符串 $x$ 的长度。
通俗地,即最长公共前后缀的长度。
如果将字符串 $s$ 看做成一个数组,以下标 $1$ 为起点,那么定义 $\pi_i$ 为 $s$ 的长度为 $i$ 的前缀的 Border,该数组被称为 $s$ 的 Next 数组。
举个例子:
$\texttt{ababbaababa}$ 的公共前后缀为 $\texttt{a},\texttt{aba}$,其中最长的长度为 3,所以它的 Border 为 3。
它的 Next 数组为:0,0,1,2,0,1,1,2,3,4,3,这可以很容易推出来。
如何计算 Next 数组?
根据一般的思路,首先需要知道如何求出每个字符串的 Border。
很容易,$\mathcal{O}(n)$ 地枚举每一个长度的前缀与后缀,然后判断每对长度相同的前后缀是否相等。注意此处暴力判还要加一个 $\mathcal{O}(n)$,用 Hash 就可以降到 $\mathcal{O}(1)$ 了。这还仅仅是求一个字符串的 Border 的复杂度。
所以求 Next 数组的复杂度就是 $\mathcal{O}(n^2)$ 或 $\mathcal{O}(n^3)$。
现在考虑优化这个过程。
2、Next 数组的线性求法
想要 $\mathcal{O}(n)$ 地求 Next 数组,显然就不能采取直接模拟 Next 数组定义的方式了。
所以现在需要抓住每个 Next 数组中的值的联系,像 DP 一样把它求出来。
不妨先考虑 $\pi_i$ 与 $\pi_{i-1}$ 的联系。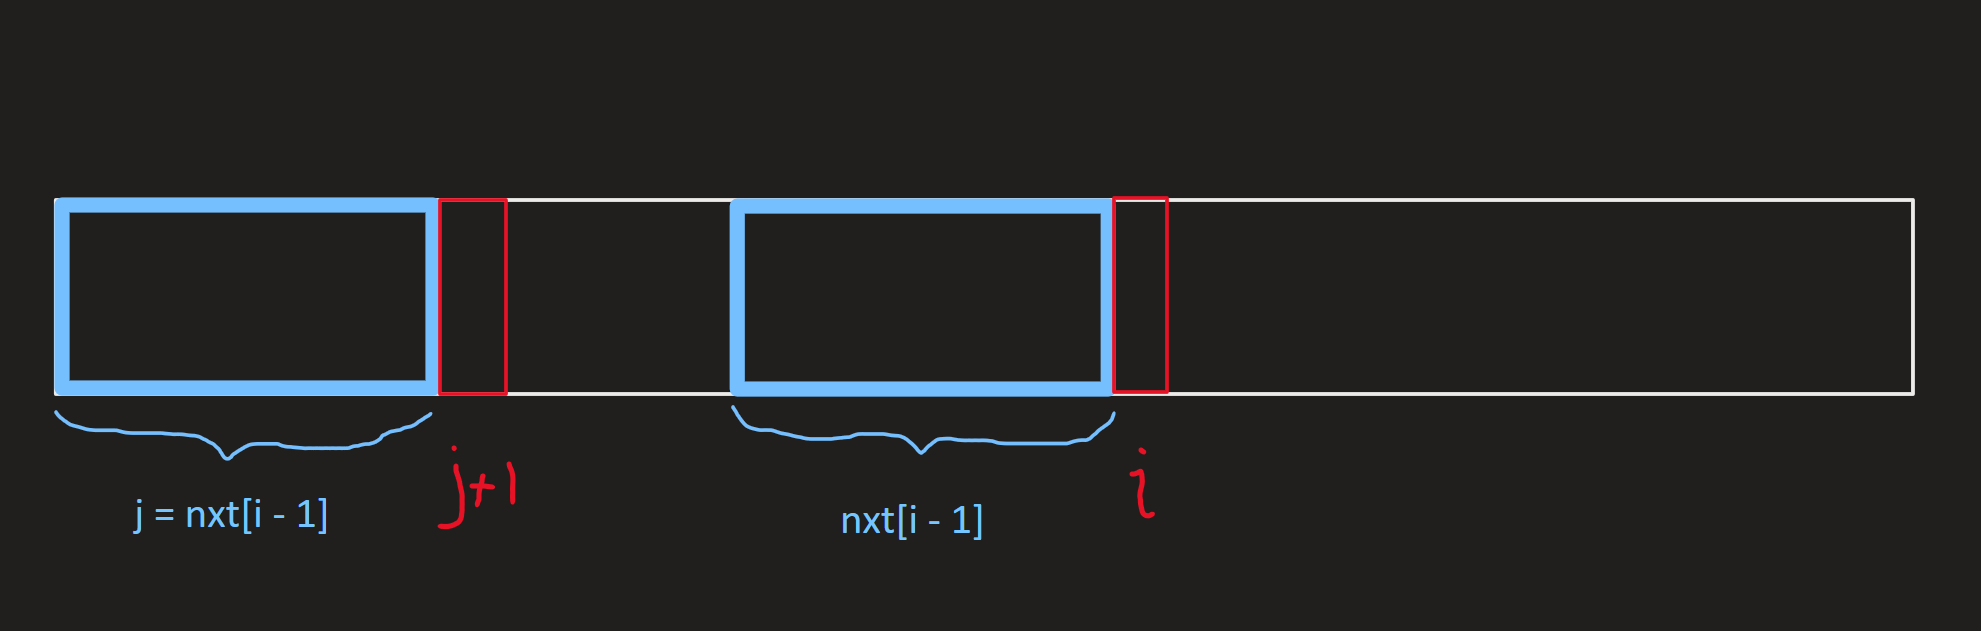
如果 $s_i=s_{j+1}$,那么如图,$\pi_i=\pi_{i-1}+1$。
此处有一个性质,$\forall i,\pi_i\le \pi_{i-1}+1$。
通过反证法很容易可以得到。
如果 $s_i\neq s_{j+1}$,那么由下图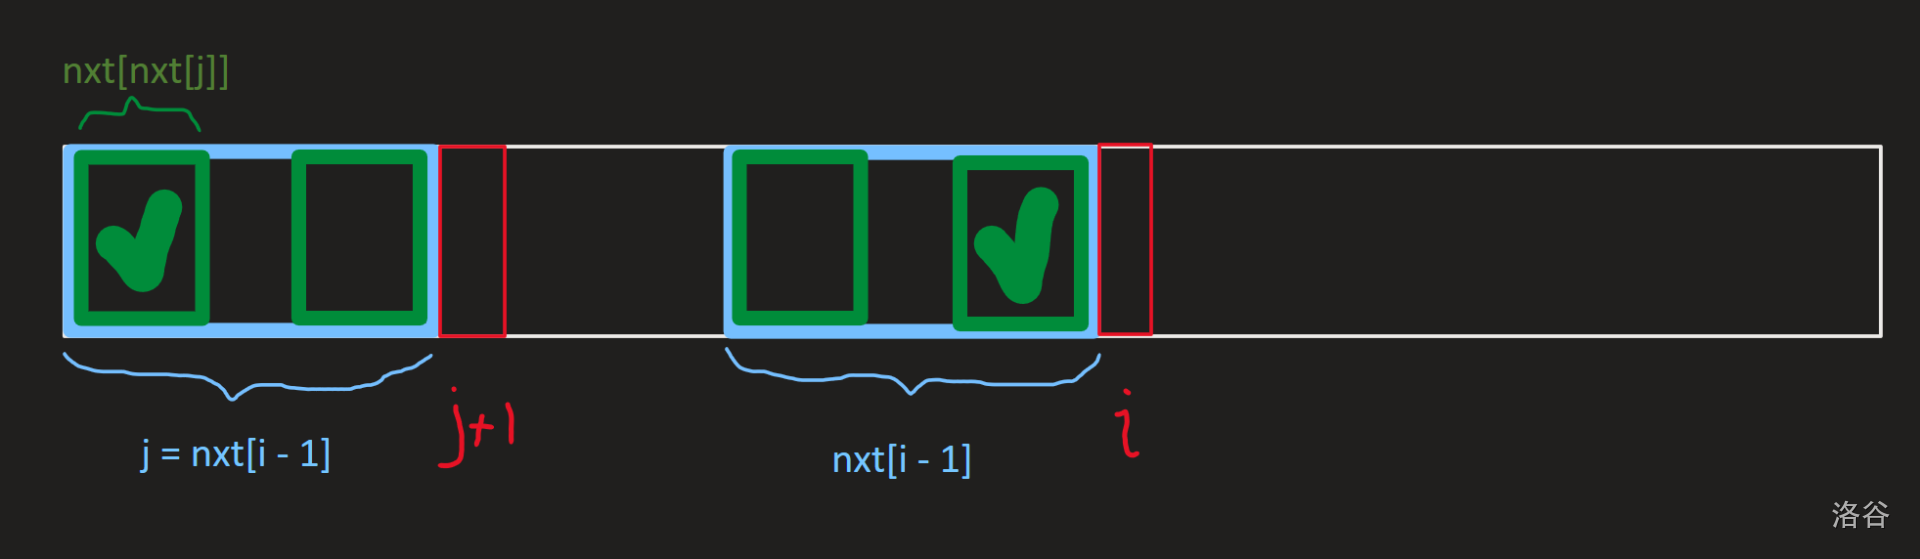
我们让 $j\gets \pi_j$,此时四个绿框中的子串都相等。再判断 $s_i$ 是否等于 $s_{j+1}$,如果不相等,再让 $j\gets \pi_j$,直到 $j$ 为 0 或相等为止。
代码如下:
1 | |
尽管这是一个 for 嵌套一个 while,但复杂度仍是 $\mathcal{O}(n)$,感性理解即可。
5. 解决问题
把 $s,t$ 前后拼起来,中间加一个随便什么字符(如‘#’),求一个 $nxt$ 数组即可。
l